AI · INFRASTRUKTURA · WYKRYWANIE ANOMALII
AI w monitoringu infrastruktury krytycznej: anomalie, fałszywe alarmy i rola operatora
Wartość analizy AI mierzy się tym, jak pomaga ocenić rzeczywiste zdarzenia. Pokazujemy, jakie dane, scenariusze i mierniki powinny znaleźć się w rzetelnej demonstracji.
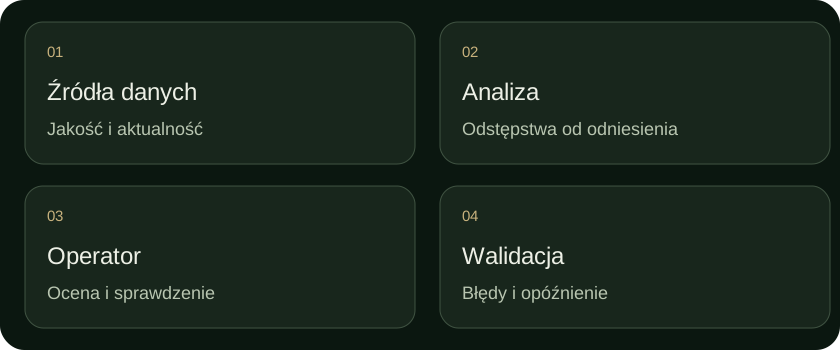
Anomalia w danych nie jest jeszcze potwierdzonym zagrożeniem
W monitoringu infrastruktury krytycznej odchylenie od normalnego działania może mieć wiele przyczyn. Nagły wzrost poboru energii może wynikać z awarii, zmiany obciążenia albo planowanego uruchomienia urządzenia. Sam alarm nie rozstrzyga, które wyjaśnienie jest prawdziwe.
Analiza AI ma sens wtedy, gdy pomaga operatorowi dostrzec zdarzenie, połączyć je z kontekstem i sprawdzić przyczynę. Dobry projekt opisuje zarówno sygnały, które chce wykrywać, jak i sytuacje, w których system powinien zgłosić brak wiarygodnych danych. Widok wykresu z napisem „AI” nie jest jeszcze dowodem skuteczności.
NIST AI Risk Management Framework wskazuje znaczenie ważności i niezawodności wyników, udokumentowanych ograniczeń oraz oceny w kontekście zastosowania. W monitoringu można potraktować to jako podstawę planu testów, a nie jako deklarację zgodności konkretnego produktu. Źródło: NIST AI RMF Core.
Najpierw określ obiekt i źródła danych
Przed wyborem modelu AI warto zdefiniować, co właściwie monitorujemy: pojedyncze urządzenie, instalację, budynek czy proces. Następnie ustalamy, jakie dane są dostępne, jak często docierają i kto odpowiada za ich jakość. Bez tego trudno określić znaczenie alarmu.
Dla przykładowej instalacji można zestawić pomiary temperatury z obciążeniem urządzenia i historią prac serwisowych. Nie oznacza to, że każda platforma ma gotową integrację ze wszystkimi czujnikami. Formaty, dostęp i synchronizacja czasu są wymaganiami do sprawdzenia w konkretnym projekcie.
Przydatny opis każdego strumienia obejmuje jednostkę pomiaru, czas zdarzenia, czas odbioru, identyfikator źródła oraz informację o brakach. Brak pomiaru powinien być odróżniony od wartości zerowej. Inaczej system może pomylić utratę łączności z poprawnym stanem obiektu.
Co oznacza normalne działanie infrastruktury?
Model odniesienia powinien obejmować rzeczywiste tryby pracy. Inne zachowanie może być typowe w dzień, inne w nocy, podczas konserwacji albo w okresie zwiększonego obciążenia. Próg, który dobrze działa w jednym trybie, może generować nadmiar alarmów w drugim.
Przykład projektowy: temperatura TEST-SENSOR-01 rośnie podczas planowanego testu urządzenia. Operator potwierdza, że zdarzenie było oczekiwane. Ta informacja może pomóc ocenić późniejsze alarmy, jeżeli proces przewiduje weryfikację i właściwe wykorzystanie danych. Nie należy bez kontroli uznawać każdej wcześniejszej decyzji za prawdę referencyjną.
Warto porównać podejście AI z prostą regułą bazową, taką jak ustalony próg lub warunek zależny od trybu pracy. Rozbudowany model powinien wykazać korzyść w wybranym zadaniu: lepszą wykrywalność, mniej zbędnych alarmów albo użyteczniejszy kontekst dla operatora.
Jak mierzyć wykrywanie anomalii i fałszywe alarmy?
Ogólna „skuteczność 99%” jest niewystarczająca bez opisu zbioru testowego. Jeżeli zdarzenia wymagające reakcji są rzadkie, model pomijający je wszystkie może mimo tego prawidłowo opisać dużą część obserwacji. Dlatego należy analizować rodzaje błędów i ich konsekwencje.
| Miernik | Na jakie pytanie odpowiada? |
|---|---|
| Wykrywalność, czyli recall | Jaką część zdarzeń wymagających reakcji wykryto? |
| Precyzja alarmów, czyli precision | Jaka część alarmów dotyczyła rzeczywistych zdarzeń? |
| Fałszywe alarmy na godzinę lub obiekt | Jakie dodatkowe obciążenie ponosi operator? |
| Opóźnienie wykrycia | Ile czasu mija od zdarzenia do dostępnego alarmu? |
| Dostępność danych | Jak często analiza działa na kompletnych i aktualnych pomiarach? |
Przykład liczbowy wyłącznie na potrzeby artykułu: w zbiorze testowym oznaczono 20 zdarzeń wymagających reakcji. System wykrył 16 z nich i wygenerował 8 dodatkowych, fałszywych alarmów. Wykrywalność wynosi 16/20, czyli 80%, a precyzja 16/24, czyli około 67%. To nie są wyniki Authify ani pomiary z infrastruktury klienta.
Takie wyniki nadal wymagają interpretacji. Pominięcie zdarzenia o wysokich konsekwencjach może być ważniejsze niż kilka zbędnych alarmów, ale nadmierna liczba powiadomień również utrudnia pracę. Akceptowalne wartości należy ustalić z użytkownikami przed oceną demonstracji.
Analiza w czasie rzeczywistym: co dokładnie mierzymy?
„W czasie rzeczywistym” powinno oznaczać konkretny wymóg dla całego procesu. Trzeba zmierzyć czas od powstania zdarzenia, przez transmisję i analizę, do wyświetlenia informacji operatorowi. Szybkie wykonanie samego modelu nie gwarantuje szybkiego powiadomienia.
Do planu testów warto włączyć opóźnione pomiary, utratę źródła, niezgodne znaczniki czasu i ponowne połączenie. Interfejs powinien wskazywać aktualność danych oraz odróżniać ocenę bieżącą od wyniku opartego na wcześniejszej próbce. Przy braku danych potrzebny jest jawny stan, zamiast pozornego potwierdzenia bezpieczeństwa.
Rola operatora i historia decyzji
Użyteczny alarm powinien pozwalać ustalić, jakiego obiektu dotyczy, co się zmieniło, z jakich danych korzysta ocena oraz jakie informacje trzeba jeszcze sprawdzić. Operator może wtedy porównać wynik z planem prac, stanem urządzenia i innymi źródłami.
Przykładowa historia zdarzenia obejmuje czas alarmu, powiązane pomiary, osobę oceniającą i wynik sprawdzenia. Jeżeli alarm uznano za oczekiwany, warto zapisać powód. To pomaga później analizować działanie procesu, ale wymaga odpowiednich uprawnień i zasad przechowywania dokumentacji.
Zmiana warunków, czujnika lub konfiguracji może wpłynąć na wyniki. Dlatego ocena nie kończy się wraz z pierwszą demonstracją. NIST AI RMF Playbook omawia dokumentowanie testów i analizę informacji zwrotnych dotyczących działania systemu w ustalonych granicach. Źródło: NIST AI RMF Playbook — Measure.
Co powinien pokazać rzetelny demonstrator?
Dobry demonstrator analizy infrastruktury AI powinien obejmować co najmniej normalny przebieg, zdarzenie wymagające oceny, oczekiwaną zmianę trybu pracy i brak źródła danych. Scenariusze syntetyczne należy tak oznaczyć. Wyniki uzyskane na danych testowych nie mogą być przedstawiane jako potwierdzenie gotowości do dowolnego wdrożenia.
Przed pokazem ustalamy cel, punkt odniesienia i mierniki. Po pokazie zapisujemy również ograniczenia: nieweryfikowane typy zdarzeń, warunki otoczenia, wymagania dotyczące operatora i zakres dostępnych integracji. Z takiej dokumentacji łatwiej wyprowadzić kolejny etap prac.
Authify rozwija analizę infrastruktury wspieraną przez AI jako obszar Defence, określany na stronie jako Threat Intelligence. Chodzi o monitoring i ryzyko operacyjne, a nie deklarację gotowej platformy cyber threat intelligence. Analiza w czasie rzeczywistym pozostaje celem wymagającym walidacji; nie publikujemy tutaj wyników wdrożenia ani gotowej obsługi każdego czujnika.
Pytania o AI i monitoring infrastruktury
Czy anomalia oznacza awarię lub atak?
Nie zawsze. Anomalia wskazuje odstępstwo wymagające oceny w kontekście obiektu i warunków działania.
Czy AI zastępuje operatora?
W opisanym podejściu wspiera ocenę sytuacji. Zakres automatyzacji i odpowiedzialność wymagają osobnych ustaleń.
Jak porównać dwie demonstracje?
Należy porównać je na jasno opisanych danych i scenariuszach, korzystając z tych samych definicji zdarzeń, błędów oraz czasu reakcji.